缩小过拟合的秘诀 Keras (过拟合怎么调参)
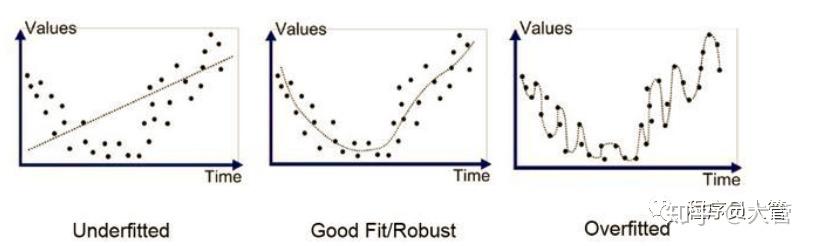
本文目录导航:
【Keras】缩小过拟合的秘诀——Dropout正则化
摘要:Dropout正则化是最便捷的神经网络正则化方法。
在Keras框架中,它能协助缩小过拟合,经过在神经网络训练时随机摈弃一局部节点来提高模型的泛化才干。
上方咱们将具体引见如何在深度学习神经网络模型中运行Dropout正则化。
Dropout正则化原理便捷,它在神经网络的训练环节中随机摈弃一局部节点,从而模拟了具备少量不同网络结构的神经网络。
这种方法增强了模型的鲁棒性,由于节点在不同迭代中被随机摈弃或保管,这有助于防止适度依赖特定节点。
在Keras中,咱们可以经过便捷的API将Dropout正则化增加到模型中,包括创立Dropout层、将Dropout正则化运行于MLP、CNN和RNN等经常出现的网络类型。以下是成功步骤:
接上去,咱们将Dropout正则化运行于经常出现的网络类型,以缩小过拟合:
此外,还引见了经常使用Dropout的初级技术,如空间摈弃(Spatial Dropout),以及如何在循环神经网络中运行变分循环神经网络(Variational RNN)。
为了验证Dropout正则化的成果,咱们可以将其运行于一个便捷的二元分类疑问,经常使用神经网络启动训练,并比拟有无Dropout正则化的状况。
结果标明,经常使用Dropout正则化后,模型在测试集上的功能有所提高,而过拟合现象失掉了有效缓解。
最后,文章还提供了拓展浏览资源,包括关系论文、博文和API文档,以便读者进一步深化了解Dropout正则化在Keras框架中的运行。
经过浏览本文,您将把握如何在Keras中经常使用Dropout正则化,以及它在缩小过拟合方面的运行,从而优化深度学习神经网络模型的功能和泛化才干。
keras.layers.Embedding的经常使用
在深度学习畛域,Keras框架中的Embedding层是一个外围组件,它担任将团圆的整数索引映射为延续的高维向量。
这一层通常作为神经网络模型的第一层经常使用。
Embedding层的输入是一个二维数组,其状态通常为(batch_size, max_sequence_length),而输入则是一个三维数组,状态为(batch_size, max_sequence_length, embedding_vector_size)。
Embedding层的成功蕴含两种重要方式:1. 可训练的嵌入向量:在这种状况下,嵌入向量是经过随机初始化失掉的,而后在训练环节中始终降级优化。
2. 预训练的嵌入向量:经常使用曾经训练好的嵌入矩阵,如word2vec,经过索引间接检索矩阵中的对应行,以此来失掉预先定义的向量示意。
在Keras中,``类的结构函数接受以下关键参数:- `input_dim`:示意词汇表的大小。
- `output_dim`:示意嵌入向量的维度。
- `input_length`:指定输入序列的长度。
Embedding层的输入是一个状态为(batch_size, input_length)的二维张量,输入则是一个状态为(batch_size, input_length, output_dim)的三维张量。
以下是一个经常使用随机初始化嵌入向量的示例代码:```pythonfrom import Embedding# 假定词汇表大小为,嵌入向量维度为100embedding = Embedding(input_dim=, output_dim=100)```假设你有预训练的word2vec模型,可以经过以下方式加载预训练的嵌入矩阵:```python# 假定pretrained_embeddings是一个状态为(vocab_size, embedding_vector_size)的预训练嵌入矩阵from import Constantembedding = Embedding(input_dim=, output_dim=100, embeddings_initializer=Constant(pretrained_embeddings))```请留意,在实践运行中,你须要依据实践状况调整参数和代码。
教你如何用Keras搭建分类神经网络
摘要:本文经过Keras成功了一个用于分类学习的案例,并具体引见了MNIST手写体识别数据集。
本文分享自华为云社区《[Python人工默认] 十七搭建分类神经网络及MNIST数字图像案例剖析》,作者:eastmount。
一. 什么是分类学习
分类学习属于有监视学习,重要用于预测团圆值的类别。
例如,判别一张图片是猫还是狗,这须要经过火类学习,将图片分类为预约义的类别之一(猫或狗)。
分类模型经过学习历史数据,构建指标函数,以预测新数据集的未知属性。
分类模型通常包括训练和测试两个阶段。
数据集被分红训练集和测试集,训练集用于构建分类模型,而测试集用于评价模型的功能。
回归与分类的重要区别在于:回归预测延续数值,如预测屋宇多少钱;而分类预测团圆类别,如判别能否患糖尿病。
二. MNIST 数据集
MNIST数据集是一个经典的手写数字识别数据集。
它蕴含少量手写数字图片,用于启动分类试验。
数据集分为训练集、验证集和测试集。
训练集用于训练模型,验证集用于验证模型的正确性,测试集用于评价模型在未知数据上的功能。
MNIST数据集由手写数字图片及其对应的标签组成。
每个样本蕴含一个28x28像素的图片和一个数字标签。
训练数据集以784维向量的方式存储,其中第一维示意图片编号,第二维示意像素值。
数据集的标签是10个类别的向量示意。
例如,数字3会被示意为[0,0,0,1,0,0,0,0,0,0]。
训练数据集中的标签存储在x10的二维数组中。
三. Keras成功MNIST分类
本文经常使用Keras搭建了一个用于MNIST数据集分类的神经网络。
该网络由输入层、暗藏层和输入层组成。
网络构建的步骤如下:
训练环节中,误差始终减小,正确率始终提高。
最终测试结果标明,模型在MNIST数据集上的功能良好。
经过上述步骤,咱们成功经常使用Keras搭建了一个用于分类学习的案例,并运行到MNIST手写体识别数据集上。
这样的案例有助于了解和通常深度学习中的分类疑问。
 phper